Sie veröffentlichen eine Seite, warten eine Woche, und sie taucht immer noch nicht bei Google auf. Die Search Console sagt „Erkannt“ oder „Gecrawlt“, aber nicht indexiert. Sie werden nicht abgestraft, und technisch ist nichts kaputt. Die Seite hat einfach die Hürde für den Google-Index nicht genommen.
Das ist eines der häufigsten und meistmissverstandenen SEO-Probleme, denn in den Google-Index zu kommen ist nicht ein Schritt, sondern zwei: Ihre Seite muss gecrawlt werden, und dann muss Google entscheiden, dass sie eine Indexierung wert ist. Dieser Leitfaden erklärt den Unterschied, zeigt Ihnen, was die Search Console wirklich sagt, geht die echten Gründe durch, warum Seiten nicht indexiert werden, und räumt mit dem Crawl-Budget-Mythos auf, der so viel Zeit kostet.
Crawling und Indexierung sind zwei verschiedene Schritte
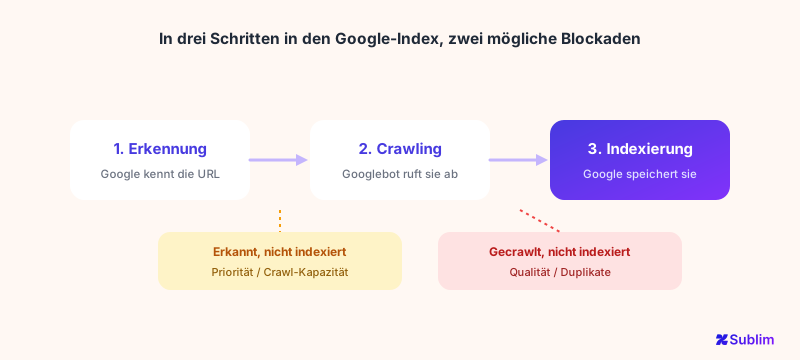
Man sagt „Google hat meine Seite nicht gecrawlt“ und meint eigentlich „Google hat sie nicht indexiert“. Das sind aber getrennte Phasen, und zu wissen, welche gescheitert ist, sagt Ihnen, was zu tun ist.
Eine Seite kann in jeder dieser Phasen stecken bleiben, und die Lösung ist jedes Mal völlig anders. Eine Seite, die aufs Crawling wartet, hat ein Erkennungs- oder Prioritätsproblem. Eine Seite, die gecrawlt, aber nicht indexiert wurde, hat ein Qualitäts- oder Duplikatsproblem. Dass so viele „Korrekturen“ nichts bewirken, liegt genau daran, dass diese beiden Fälle verwechselt werden.
Was die Search Console Ihnen wirklich sagt
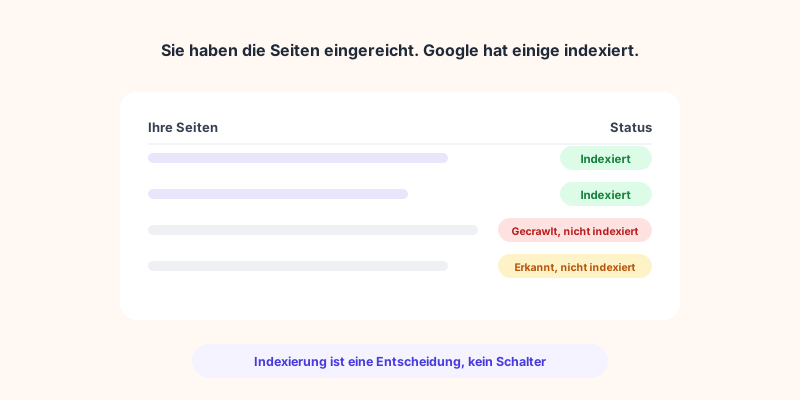
Der Bericht zur Seitenindexierung von Google weist jeder ausgeschlossenen Seite einen konkreten Status zu. Die meisten schauen nie über die Zahl hinaus. Hier sind die Status, die Ihnen tatsächlich begegnen, und was jeder wirklich bedeutet:
| Status | Was es wirklich bedeutet |
|---|---|
| Erkannt, zurzeit nicht indexiert | Google kennt die URL, hat sie aber noch nicht gecrawlt. Oft ein Signal für Priorität oder Crawl-Kapazität. |
| Gecrawlt, zurzeit nicht indexiert | Google hat die Seite gelesen und sich gegen eine Indexierung entschieden. Meist ein Signal für die Inhaltsqualität. |
| Duplikat ohne vom Nutzer ausgewählte kanonische Seite | Google sieht die Seite als Beinahe-Duplikat und hat stattdessen eine andere Version indexiert. |
| Duplikat, Google hat eine andere kanonische Seite gewählt als der Nutzer | Sie haben ein Canonical gesetzt, Google hat es übergangen und eine andere Seite gewählt. |
| Durch „noindex“-Tag ausgeschlossen | Die Seite sagt Google, sie nicht zu indexieren. Oft versehentlich. |
| Durch robots.txt blockiert | Der Googlebot durfte sie nicht einmal crawlen. |
| Soft 404 | Die Seite wirkt für Google leer oder fehlerhaft, selbst wenn sie den Code 200 zurückgibt. |
Der Status ist die Diagnose. „Gecrawlt, nicht indexiert“ und „Erkannt, nicht indexiert“ verweisen auf völlig verschiedene Probleme: Beginnen Sie also immer hier, bevor Sie irgendetwas ändern.
Warum Ihre Seiten nicht indexiert werden
Lässt man die Etiketten beiseite, laufen fast alle Fälle auf eine Handvoll Ursachen hinaus:
- Dünner oder geringwertiger Inhalt. Der häufigste Grund hinter „Gecrawlt, zurzeit nicht indexiert“. Google hat die Seite gecrawlt, für nicht speicherwürdig befunden und ist weitergezogen. Die üblichen Opfer sind Seiten, die nur wiederholen, was Dutzende andere schon sagen.
- Duplikate und Canonical-Verwirrung. Nahezu identische Seiten (Produktvarianten, gefilterte URLs, Textbausteine) bringen Google dazu, eine zu behalten und den Rest zu verwerfen. Fehlende oder widersprüchliche Canonical-Tags verschlimmern das.
- Versehentliches noindex oder robots.txt-Blockaden. Ein verirrtes
noindexaus einem Template oder eine pauschalerobots.txt-Regel kann ganze Bereiche stillschweigend aussperren. Immer zuerst prüfen, denn es ist ein Einzeiler. - Schwache interne Verlinkung (verwaiste Seiten). Wenn nichts auf Ihrer Website auf eine Seite verlinkt, priorisiert Google ihr Crawling womöglich nie. Erkennung und Crawl-Priorität hängen stark von internen Links ab.
- Soft 404 und technische Fehler. Leere Seiten, kaputte Templates oder fehlerähnliche Antworten sagen Google, dass es nichts zu indexieren gibt.
Ist das Crawl-Budget Ihr Problem? (Fast nie)
Sobald es um Indexierung geht, macht jemand das „Crawl-Budget“ verantwortlich. Für die allermeisten Websites ist das ein Ablenkungsmanöver. Googles eigene Anleitung zum Verwalten des Crawl-Budgets ist deutlich: Sie richtet sich an große Websites (über 1 Million Seiten) oder mittelgroße Websites (über 10.000 Seiten) mit sehr schnell wechselnden Inhalten. Google sagt klar, dass Sie diese Anleitung gar nicht lesen müssen, wenn Ihre Seiten in der Regel am selben Tag gecrawlt werden, an dem sie veröffentlicht wurden.
Wenn Sie also eine normale Unternehmensseite, einen Blog oder einen Shop mit ein paar hundert oder tausend Seiten betreiben, ist das Crawl-Budget nicht der Grund für Ihre fehlenden Seiten. Die echte Ursache ist fast immer Qualität oder Duplikate, nicht die Crawl-Kapazität. Auf einer kleinen Website dem Crawl-Budget hinterherzujagen ist Zeit, die Sie dem echten Problem widmen sollten.
So beheben Sie es, Schritt für Schritt
- Starten Sie im Bericht zur Seitenindexierung. Gruppieren Sie die nicht indexierten Seiten nach Status. Der Status sagt Ihnen, welches Problem Sie haben, bevor Sie irgendetwas ändern.
- Schließen Sie versehentliche Blockaden zuerst aus. Prüfen Sie auf verirrte
noindex-Tags undrobots.txt-Regeln. Das sind schnelle Siege, die ganze Bereiche freischalten können. - Beheben Sie Duplikate. Setzen Sie klare Canonical-Tags, führen Sie nahezu identische Seiten zusammen und machen Sie jede verbleibende Seite wirklich eigenständig.
- Stärken Sie dünne Inhalte oder entfernen Sie sie. Bei „Gecrawlt, nicht indexiert“ machen Sie die Seite entweder deutlich nützlicher als die Konkurrenz, oder Sie stutzen sie zurück, damit sie Ihre Website nicht länger verwässert.
- Stärken Sie die interne Verlinkung. Verlinken Sie wichtige Seiten von relevanten, bereits indexierten Seiten, damit Google sie entdeckt und priorisiert.
- Reichen Sie eine saubere Sitemap ein und nutzen Sie „Indexierung beantragen“ für wirklich wertvolle Seiten, dann haben Sie Geduld. Indexierung ist eine Entscheidung, kein Schalter.
Wie Sublim hilft
Sublim liefert Ihnen beide Hälften des Bildes an einem Ort. Sein integrierter Crawler deckt die technischen Probleme auf, die Seiten aus dem Index halten: kaputte Links, doppelte Titel, Meta-Descriptions und Inhalte, fehlende Metadaten und langsame Seiten, alles bewertet, damit Sie priorisieren können.
Und seine Search-Console-Integration zeigt Ihren Indexierungsstatus direkt an, eingereichte gegenüber indexierten Seiten, mit den von Google gemeldeten Fehlern und Warnungen.
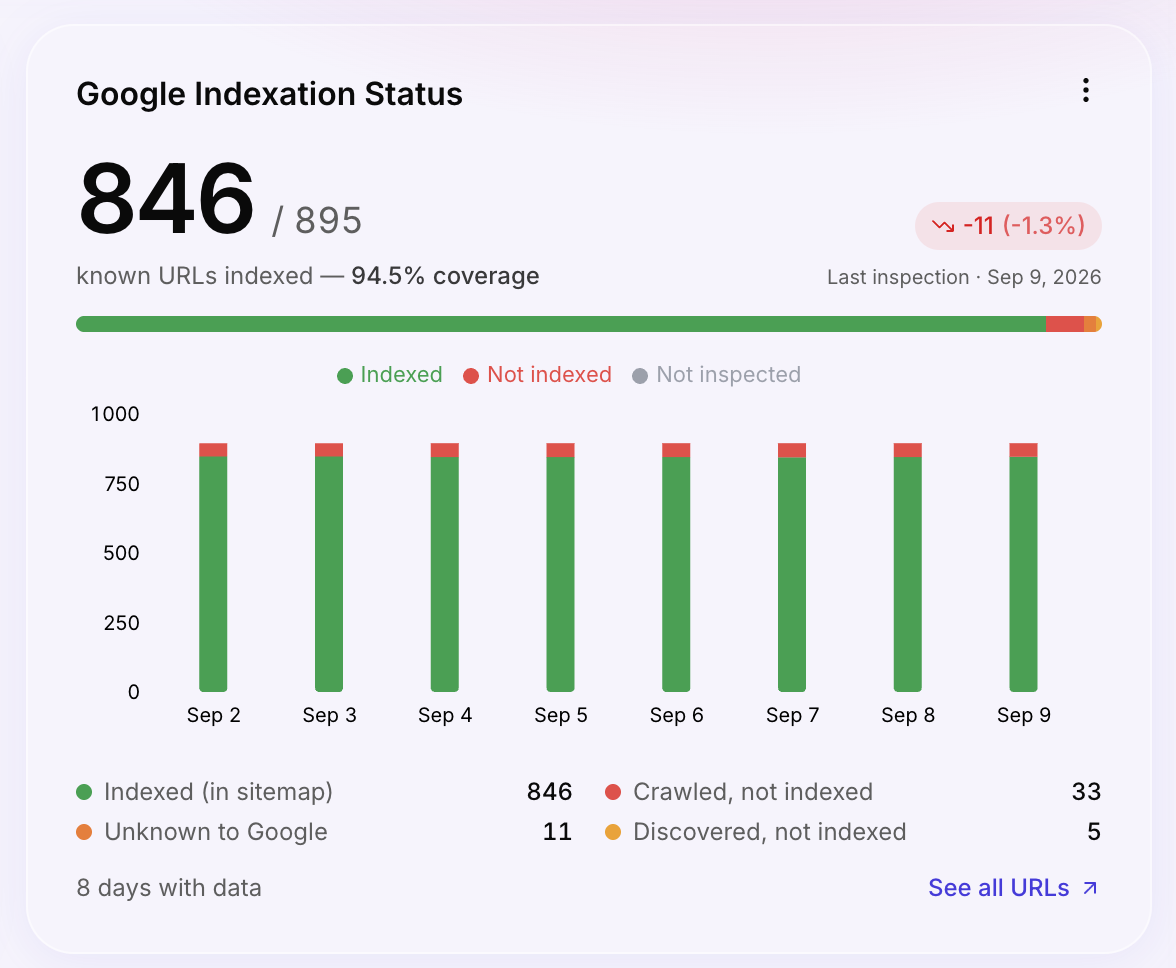
Weil Sublim zugleich Ihr Analytics ist, kann es etwas, das ein reines SEO-Tool nicht kann: Es gleicht indexierte Seiten mit echtem organischem Traffic ab, sodass Sie Seiten erkennen, die zwar indexiert sind, aber keine Besuche bekommen, jene geringwertigen Inhalte, die oft den Rest nach unten ziehen. Es wird Google nicht zwingen, eine Seite zu indexieren (das kann nichts), aber es macht die Diagnose schnell und konkret statt zum Ratespiel.