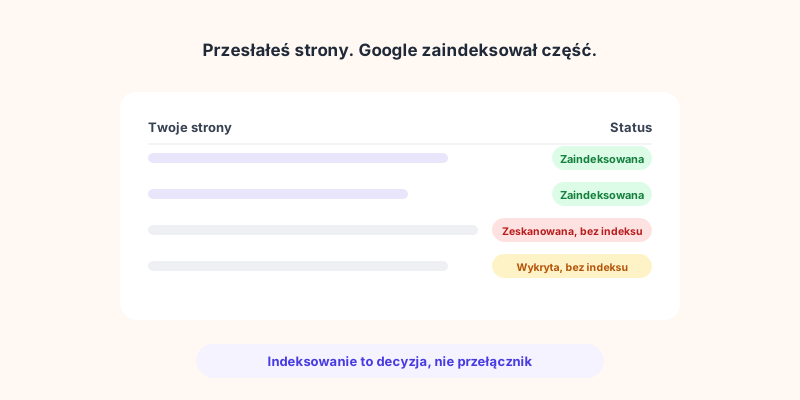
Publikujesz stronę, czekasz tydzień, a ona wciąż nie pojawia się w Google. Search Console mówi „Wykryta” lub „Zeskanowana”, ale nie zaindeksowana. Nie dostajesz kary i technicznie nic nie jest zepsute. Strona po prostu nie przeszła progu, by trafić do indeksu Google.
To jeden z najczęstszych i najbardziej niezrozumianych problemów SEO, bo wejście do Google to nie jeden krok, ale dwa: Twoja strona musi zostać zeskanowana, a potem Google musi uznać, że warto ją zaindeksować. Ten przewodnik wyjaśnia różnicę, pokazuje, jak czytać to, co Search Console naprawdę Ci mówi, omawia prawdziwe powody, dla których strony nie są indeksowane, i obala mit budżetu crawlowania, który pochłania tyle czasu.
Skanowanie i indeksowanie to dwa różne kroki
Mówimy „Google nie zeskanował mojej strony”, mając na myśli „Google jej nie zaindeksował”, ale to osobne etapy, a wiedza, który zawiódł, mówi Ci, co naprawić.
Strona może utknąć na każdym z tych etapów, a rozwiązanie jest za każdym razem zupełnie inne. Strona czekająca na zeskanowanie ma problem z wykryciem lub priorytetem. Strona zeskanowana, ale niezaindeksowana ma problem z jakością lub duplikacją. Jeśli tyle „poprawek” nic nie zmienia, to właśnie dlatego, że te dwa przypadki są mylone.
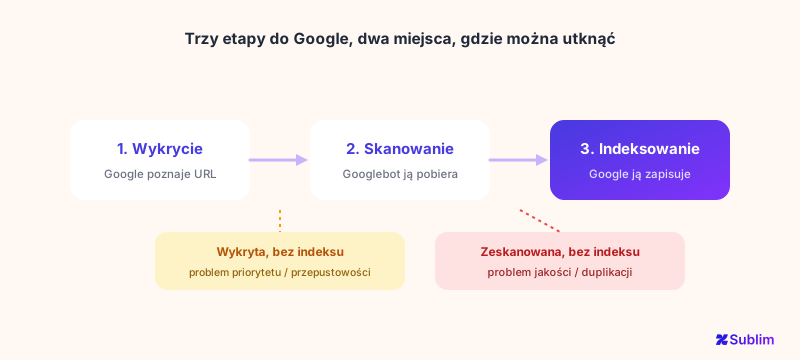
Co Search Console naprawdę Ci mówi
Raport Indeksowanie stron Google przypisuje każdej wykluczonej stronie konkretny status. Większość ludzi nigdy nie patrzy dalej niż na liczbę. Oto te, które naprawdę zobaczysz, i co każdy z nich naprawdę znaczy:
| Status | Co to naprawdę znaczy |
|---|---|
| Wykryta, obecnie niezaindeksowana | Google zna URL, ale jeszcze go nie zeskanował. Często sygnał priorytetu lub przepustowości skanowania. |
| Zeskanowana, obecnie niezaindeksowana | Google przeczytał stronę i zdecydował jej nie indeksować. Zwykle sygnał jakości treści. |
| Duplikat bez strony kanonicznej wybranej przez użytkownika | Google widzi stronę jako niemal-duplikat i zaindeksował zamiast niej inną wersję. |
| Duplikat, Google wybrał inną stronę kanoniczną niż użytkownik | Ustawiłeś kanoniczną, Google ją zignorował i wybrał inną stronę. |
| Wykluczona przez tag „noindex” | Strona mówi Google, by jej nie indeksował. Często przez przypadek. |
| Zablokowana przez plik robots.txt | Googlebot nie dostał nawet pozwolenia, by ją zeskanować. |
| Miękki błąd 404 | Strona wygląda dla Google na pustą lub błędną, nawet jeśli zwraca kod 200. |
Status to diagnoza. „Zeskanowana, niezaindeksowana” i „Wykryta, niezaindeksowana” wskazują na zupełnie różne problemy: zawsze zaczynaj tutaj, zanim czegokolwiek dotkniesz.
Dlaczego Twoje strony nie są indeksowane
Gdy odrzucisz etykiety, niemal każdy przypadek sprowadza się do garstki przyczyn:
- Uboga lub niskiej wartości treść. Najczęstszy powód za „Zeskanowana, obecnie niezaindeksowana”. Google zeskanował stronę, uznał, że nie warto jej zapisać, i poszedł dalej. Zwykłymi ofiarami są strony, które powtarzają to, co dziesiątki innych już mówią.
- Duplikacja i zamieszanie z kanonicznymi. Niemal identyczne strony (warianty produktu, filtrowane adresy URL, powtarzalny tekst) skłaniają Google do wybrania jednej i odrzucenia reszty. Brakujące lub sprzeczne tagi kanoniczne pogarszają sprawę.
- Przypadkowe blokady przez noindex lub robots.txt. Zabłąkany
noindexz szablonu albo ogólna regułarobots.txtmogą po cichu wykluczyć całe sekcje. Warto sprawdzić to najpierw, bo to poprawka na jedną linijkę. - Słabe linkowanie wewnętrzne (strony osierocone). Jeśli nic w Twojej witrynie nie linkuje do strony, Google może nigdy nie nadać priorytetu jej skanowaniu. Wykrycie i priorytet skanowania mocno zależą od linków wewnętrznych.
- Miękkie błędy 404 i błędy techniczne. Puste strony, zepsute szablony lub odpowiedzi przypominające błąd mówią Google, że nie ma nic do zaindeksowania.
Czy budżet crawlowania to Twój problem? (Prawie nigdy)
Za każdym razem, gdy pojawia się temat indeksowania, ktoś obwinia „budżet crawlowania”. Dla ogromnej większości witryn to fałszywy trop. Sam poradnik Google o zarządzaniu budżetem crawlowania jest jednoznaczny: jest napisany dla dużych witryn (ponad 1 milion stron) lub średnich (ponad 10 000 stron) z bardzo szybko zmieniającą się treścią. Google wprost mówi, że jeśli Twoje strony są zwykle skanowane tego samego dnia, w którym je publikujesz, wcale nie musisz czytać tego poradnika.
Więc jeśli prowadzisz zwykłą witrynę firmową, blog albo sklep z kilkuset lub kilkoma tysiącami stron, budżet crawlowania nie jest powodem brakujących stron. Prawdziwą przyczyną prawie zawsze jest jakość lub duplikacja, a nie przepustowość skanowania. Gonienie za budżetem crawlowania na małej witrynie to czas, który powinieneś poświęcić prawdziwemu problemowi.
Jak to naprawić, krok po kroku
- Zacznij od raportu Indeksowanie stron. Pogrupuj niezaindeksowane strony według statusu. Status mówi Ci, jaki masz problem, zanim cokolwiek zmienisz.
- Najpierw wyklucz przypadkowe blokady. Sprawdź zabłąkane tagi
noindexi regułyrobots.txt. To szybkie zwycięstwa, które mogą odblokować całe sekcje. - Napraw duplikację. Ustaw jasne tagi kanoniczne, połącz niemal identyczne strony i spraw, by każda pozostała strona była naprawdę odrębna.
- Wzmocnij ubogą treść albo ją usuń. Przy „Zeskanowana, niezaindeksowana” albo uczyń stronę znacznie bardziej użyteczną od konkurencji, albo ją przytnij, by przestała rozwadniać Twoją witrynę.
- Wzmocnij linki wewnętrzne. Linkuj do ważnych stron z powiązanych, już zaindeksowanych stron, aby Google je wykrył i nadał im priorytet.
- Prześlij czystą mapę witryny i użyj „Poproś o zindeksowanie” dla naprawdę wartościowych stron, a potem uzbrój się w cierpliwość. Indeksowanie to decyzja, nie przełącznik.
Jak pomaga Sublim
Sublim daje Ci obie połowy obrazu w jednym miejscu. Jego wbudowany crawler ujawnia problemy techniczne, które trzymają strony poza indeksem: zepsute linki, zduplikowane tytuły, meta opisy i treści, brakujące metadane oraz wolne strony, wszystko z punktacją, byś mógł ustalić priorytety.
A jego integracja z Search Console pokazuje Twój status indeksowania bezpośrednio, strony przesłane w porównaniu z zaindeksowanymi, wraz z błędami i ostrzeżeniami zgłaszanymi przez Google.
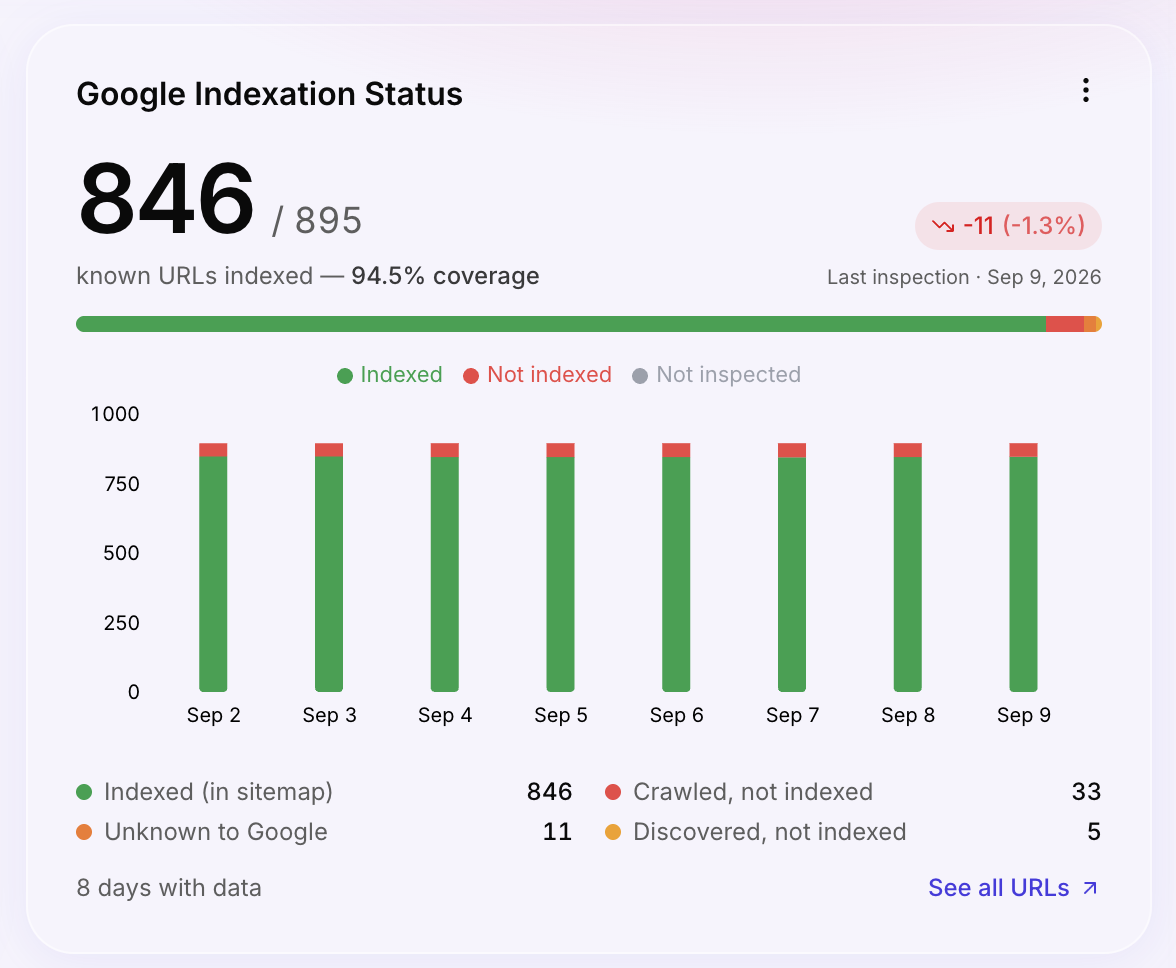
Ponieważ Sublim jest też Twoją analityką, robi coś, czego samodzielne narzędzie SEO nie potrafi: zestawia zaindeksowane strony z prawdziwym ruchem organicznym, byś wyłapał strony, które są zaindeksowane, ale nie dostają wizyt, tę niskowartościową treść, która często ciągnie resztę w dół. Nie zmusi Google do zaindeksowania strony (nic tego nie zrobi), ale sprawia, że diagnoza jest szybka i konkretna zamiast zgadywania.