Publicas una página, esperas una semana y sigue sin aparecer en Google. Search Console dice «Descubierta» o «Rastreada», pero no indexada. No te están penalizando y no hay nada técnicamente roto. La página simplemente no ha superado el listón para entrar en el índice de Google.
Es uno de los problemas de SEO más comunes y peor entendidos, porque entrar en Google no es un paso sino dos: tu página tiene que ser rastreada y luego Google tiene que decidir que merece la pena indexarla. Esta guía explica la diferencia, te muestra cómo leer lo que Search Console te está diciendo de verdad, repasa las razones reales por las que las páginas no se indexan y desmonta el mito del presupuesto de rastreo que tanto tiempo hace perder.
Rastreo e indexación son dos pasos distintos
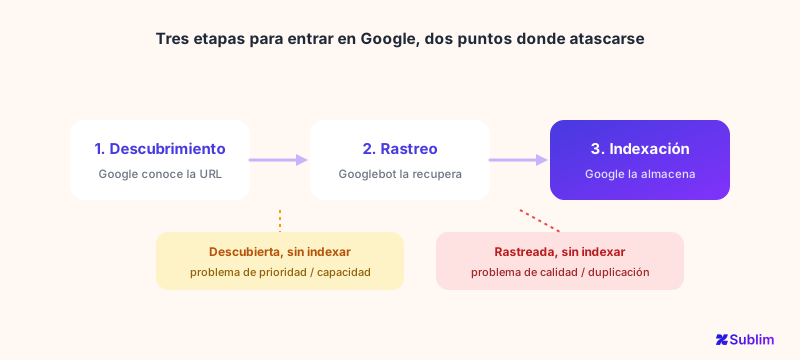
La gente dice «Google no ha rastreado mi página» cuando quiere decir «Google no la ha indexado», pero son fases separadas, y saber cuál falló te dice qué corregir.
Una página puede quedarse atascada en cualquiera de estas fases, y la solución es completamente distinta cada vez. Una página que espera a ser rastreada tiene un problema de descubrimiento o de prioridad. Una página rastreada pero no indexada tiene un problema de calidad o de duplicación. Si tantas «correcciones» no cambian nada, es justo porque se confunden estos dos casos.
Qué te está diciendo Search Console de verdad
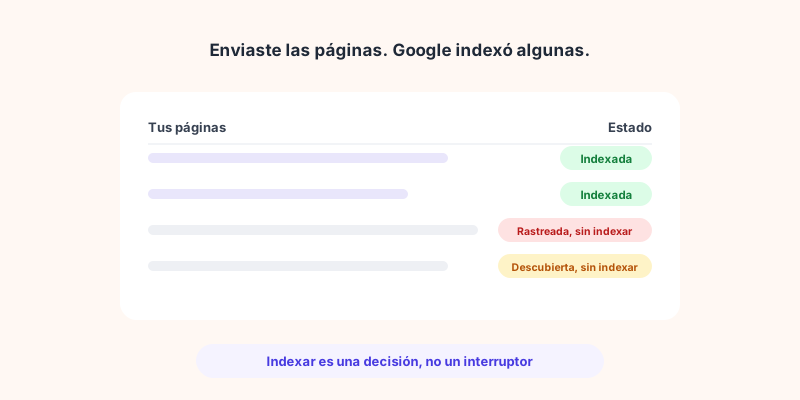
El informe de indexación de páginas de Google asigna a cada página excluida un estado concreto. La mayoría nunca mira más allá del recuento. Estos son los que verás de verdad, y lo que significa cada uno:
| Estado | Lo que significa de verdad |
|---|---|
| Descubierta: actualmente sin indexar | Google conoce la URL pero aún no la ha rastreado. A menudo una señal de prioridad o de capacidad de rastreo. |
| Rastreada: actualmente sin indexar | Google leyó la página y decidió no indexarla. Normalmente una señal de calidad del contenido. |
| Duplicada sin versión canónica seleccionada por el usuario | Google ve la página como un casi-duplicado e indexó otra versión en su lugar. |
| Duplicada: Google eligió una versión canónica distinta a la del usuario | Definiste una canónica, Google la ignoró y eligió otra página. |
| Excluida por una etiqueta «noindex» | La página le dice a Google que no la indexe. A menudo por accidente. |
| Bloqueada por robots.txt | Googlebot ni siquiera tuvo permiso para rastrearla. |
| Soft 404 | La página parece vacía o con aspecto de error para Google, aunque devuelva un código 200. |
El estado es el diagnóstico. «Rastreada, sin indexar» y «Descubierta, sin indexar» apuntan a problemas completamente distintos: empieza siempre por aquí antes de tocar nada.
Por qué no se indexan tus páginas
Si quitas las etiquetas, casi todos los casos se reducen a un puñado de causas:
- Contenido pobre o de bajo valor. La razón más común detrás de «Rastreada, actualmente sin indexar». Google rastreó la página, la juzgó no merecedora de ser guardada y siguió adelante. Las víctimas habituales son las páginas que repiten lo que decenas de otras ya dicen.
- Duplicación y confusión de canónicas. Páginas casi idénticas (variantes de producto, URLs filtradas, texto repetitivo) hacen que Google elija una y descarte el resto. Las etiquetas canónicas ausentes o contradictorias lo empeoran.
- Bloqueos accidentales por noindex o robots.txt. Un
noindexperdido en una plantilla o una regla general derobots.txtpueden dejar secciones enteras fuera en silencio. Conviene comprobarlo primero porque es una corrección de una línea. - Enlazado interno débil (páginas huérfanas). Si nada en tu sitio enlaza a una página, puede que Google nunca priorice rastrearla. El descubrimiento y la prioridad de rastreo dependen mucho de los enlaces internos.
- Soft 404 y errores técnicos. Páginas vacías, plantillas rotas o respuestas con aspecto de error le dicen a Google que no hay nada que indexar.
¿Es el presupuesto de rastreo tu problema? (Casi nunca)
Cada vez que sale el tema de la indexación, alguien culpa al «presupuesto de rastreo». Para la gran mayoría de sitios es una pista falsa. La propia guía de Google sobre gestionar el presupuesto de rastreo es tajante: está escrita para sitios grandes (más de 1 millón de páginas) o medianos (más de 10.000 páginas) con contenido que cambia muy rápido. Google dice claramente que si tus páginas suelen rastrearse el mismo día en que se publican, no necesitas leer esa guía en absoluto.
Así que si tienes un sitio de empresa normal, un blog o una tienda con unos cientos o unos miles de páginas, el presupuesto de rastreo no es la razón de que falten tus páginas. La causa real casi siempre es la calidad o la duplicación, no la capacidad de rastreo. Perseguir el presupuesto de rastreo en un sitio pequeño es tiempo que deberías dedicar al problema de verdad.
Cómo solucionarlo, paso a paso
- Empieza en el informe de indexación de páginas. Agrupa las páginas no indexadas por estado. El estado te dice qué problema tienes antes de cambiar nada.
- Descarta primero los bloqueos accidentales. Busca etiquetas
noindexperdidas y reglas derobots.txt. Son victorias rápidas que pueden liberar secciones enteras. - Corrige la duplicación. Pon etiquetas canónicas claras, consolida las páginas casi idénticas y haz que cada página superviviente sea realmente distinta.
- Mejora el contenido pobre o elimínalo. Para «Rastreada, sin indexar», o haces la página bastante más útil que la competencia, o la podas para que deje de diluir tu sitio.
- Refuerza los enlaces internos. Enlaza a las páginas importantes desde páginas relevantes ya indexadas para que Google las descubra y las priorice.
- Envía un sitemap limpio y usa «Solicitar indexación» para las páginas realmente valiosas, y luego ten paciencia. Indexar es una decisión, no un interruptor.
Cómo ayuda Sublim
Sublim te da las dos mitades del cuadro en un solo sitio. Su crawler integrado saca a la luz los problemas técnicos que mantienen las páginas fuera del índice: enlaces rotos, títulos, meta descripciones y contenidos duplicados, metadatos ausentes y páginas lentas, todo puntuado para que puedas priorizar.
Y su integración con Search Console muestra tu estado de indexación directamente, páginas enviadas frente a indexadas, con los errores y avisos que informa Google.
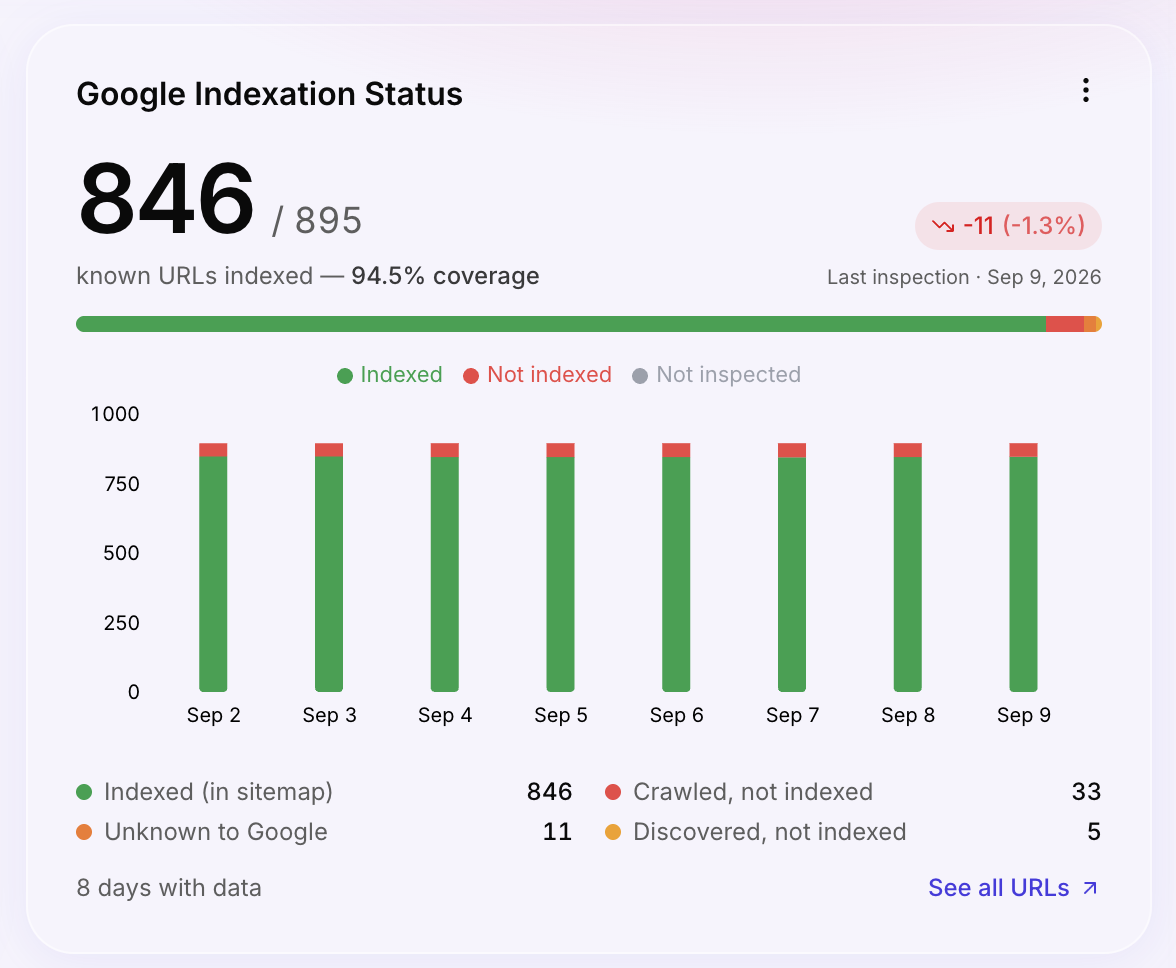
Como Sublim también es tu analítica, hace algo que una herramienta de SEO por separado no puede: cruza las páginas indexadas con el tráfico orgánico real, para que detectes las páginas que están indexadas pero no reciben visitas, ese contenido de bajo valor que a menudo arrastra al resto hacia abajo. No obligará a Google a indexar una página (nada puede hacerlo), pero hace que el diagnóstico sea rápido y concreto en lugar de una adivinanza.