Vous publiez une page, vous attendez une semaine, et elle n'apparaît toujours pas dans Google. La Search Console indique « Détectée » ou « Explorée », mais pas indexée. Vous n'êtes pas pénalisé, et rien n'est techniquement cassé. La page n'a simplement pas franchi la barre pour entrer dans l'index de Google.
C'est l'un des problèmes SEO les plus courants et les plus mal compris, parce qu'entrer dans Google ne se fait pas en une étape mais en deux : votre page doit être explorée, puis Google doit décider qu'elle mérite d'être indexée. Ce guide explique la différence, vous montre comment lire ce que la Search Console vous dit vraiment, passe en revue les vraies raisons pour lesquelles des pages ne sont pas indexées, et démonte le mythe du budget d'exploration qui fait perdre tant de temps.
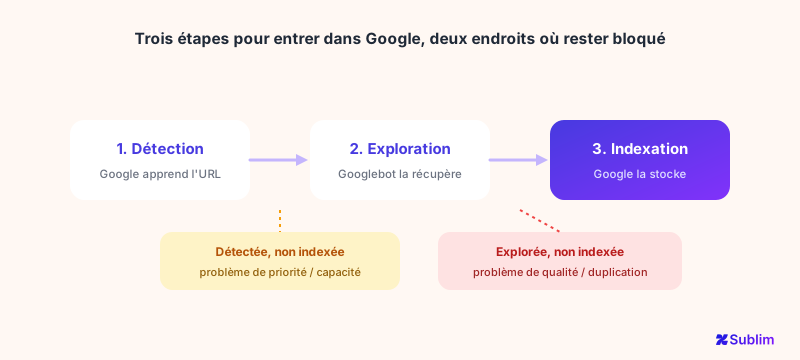
Exploration et indexation sont deux étapes distinctes
On dit « Google n'a pas exploré ma page » en voulant dire « Google ne l'a pas indexée », mais ce sont des étapes séparées, et savoir laquelle a échoué vous dit quoi corriger.
Une page peut rester bloquée à n'importe laquelle de ces étapes, et la correction est à chaque fois complètement différente. Une page qui attend d'être explorée a un problème de détection ou de priorité. Une page explorée mais non indexée a un problème de qualité ou de duplication. Si tant de « corrections » restent sans effet, c'est justement parce qu'on confond ces deux cas.
Ce que la Search Console vous dit vraiment
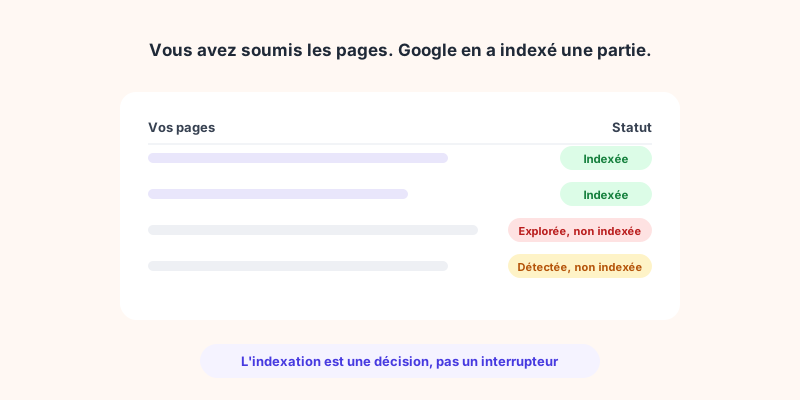
Le rapport Indexation des pages de Google attribue à chaque page exclue un statut précis. La plupart des gens ne regardent jamais au-delà du compteur. Voici ceux que vous verrez réellement, et ce que chacun signifie vraiment :
| Statut | Ce que ça veut vraiment dire |
|---|---|
| Détectée, actuellement non indexée | Google connaît l'URL mais ne l'a pas encore explorée. Souvent un signal de priorité ou de capacité d'exploration. |
| Explorée, actuellement non indexée | Google a lu la page et a choisi de ne pas l'indexer. Généralement un signal de qualité de contenu. |
| Page en double sans URL canonique sélectionnée par l'utilisateur | Google considère la page comme un quasi-doublon et a indexé une autre version à la place. |
| En double, Google n'a pas choisi la même page canonique que l'utilisateur | Vous avez défini une canonique, Google l'a ignorée et a choisi une autre page. |
| Exclue par la balise « noindex » | La page demande à Google de ne pas l'indexer. Souvent par accident. |
| Bloquée par le fichier robots.txt | Googlebot n'a même pas été autorisé à l'explorer. |
| Soft 404 | La page paraît vide ou en erreur aux yeux de Google, même si elle renvoie un code 200. |
Le statut, c'est le diagnostic. « Explorée, non indexée » et « Détectée, non indexée » pointent vers des problèmes complètement différents : commencez donc toujours par là avant de toucher à quoi que ce soit.
Pourquoi vos pages ne sont pas indexées
Une fois les étiquettes mises de côté, presque tous les cas se ramènent à une poignée de causes :
- Contenu pauvre ou à faible valeur. La raison la plus fréquente derrière « Explorée, actuellement non indexée ». Google a exploré la page, jugé qu'elle ne valait pas la peine d'être stockée, et est passé à autre chose. Les pages qui redisent ce que des dizaines d'autres disent déjà en sont les victimes habituelles.
- Duplication et confusion des canoniques. Des pages quasi identiques (variantes de produit, URLs filtrées, contenu passe-partout) poussent Google à en garder une et à jeter les autres. Des balises canoniques absentes ou contradictoires aggravent le problème.
- Blocage accidentel par noindex ou robots.txt. Un
noindexégaré dans un template ou une règlerobots.txttrop large peuvent exclure des sections entières en silence. À vérifier en premier, car c'est une correction d'une seule ligne. - Maillage interne faible (pages orphelines). Si rien sur votre site ne pointe vers une page, Google peut ne jamais prioriser son exploration. La détection et la priorité d'exploration dépendent beaucoup des liens internes.
- Soft 404 et erreurs techniques. Pages vides, templates cassés ou réponses en erreur : autant de signaux qu'il n'y a rien à indexer.
Le budget d'exploration est-il votre problème ? (Presque jamais)
Dès qu'on parle d'indexation, quelqu'un accuse le « budget d'exploration ». Pour la grande majorité des sites, c'est une fausse piste. La documentation de Google sur la gestion du budget d'exploration est catégorique : elle s'adresse aux grands sites (plus d'1 million de pages), ou aux sites moyens (plus de 10 000 pages) dont le contenu change très rapidement. Google dit clairement que si vos pages sont généralement explorées le jour même de leur publication, vous n'avez pas besoin de lire ce guide du tout.
Donc si vous gérez un site vitrine, un blog ou une boutique normale avec quelques centaines ou quelques milliers de pages, le budget d'exploration n'est pas la raison de vos pages manquantes. La vraie cause est presque toujours la qualité ou la duplication, pas la capacité d'exploration. Courir après le budget d'exploration sur un petit site, c'est du temps que vous devriez consacrer au vrai problème.
Comment corriger, étape par étape
- Partez du rapport Indexation des pages. Regroupez les pages non indexées par statut. Le statut vous dit quel problème vous avez avant même de changer quoi que ce soit.
- Écartez d'abord les blocages accidentels. Cherchez les balises
noindexégarées et les règlesrobots.txt. Ce sont des gains rapides qui peuvent libérer des sections entières. - Réglez la duplication. Posez des balises canoniques claires, regroupez les pages quasi identiques, et rendez chaque page survivante réellement distincte.
- Renforcez ou supprimez le contenu pauvre. Pour « Explorée, non indexée », soit vous rendez la page nettement plus utile que la concurrence, soit vous l'élaguez pour qu'elle cesse de diluer votre site.
- Renforcez le maillage interne. Pointez vers vos pages importantes depuis des pages pertinentes déjà indexées, pour que Google les détecte et les priorise.
- Soumettez un sitemap propre et utilisez « Demander une indexation » pour les pages réellement utiles, puis soyez patient. L'indexation est une décision, pas un interrupteur.
Comment Sublim aide
Sublim vous donne les deux moitiés du tableau au même endroit. Son crawler intégré fait remonter les problèmes techniques qui tiennent vos pages hors de l'index : liens cassés, titres, meta descriptions et contenus dupliqués, métadonnées manquantes et pages lentes, le tout noté pour que vous puissiez prioriser.
Et son intégration Search Console affiche directement votre statut d'indexation, pages soumises vs indexées, avec les erreurs et avertissements remontés par Google.
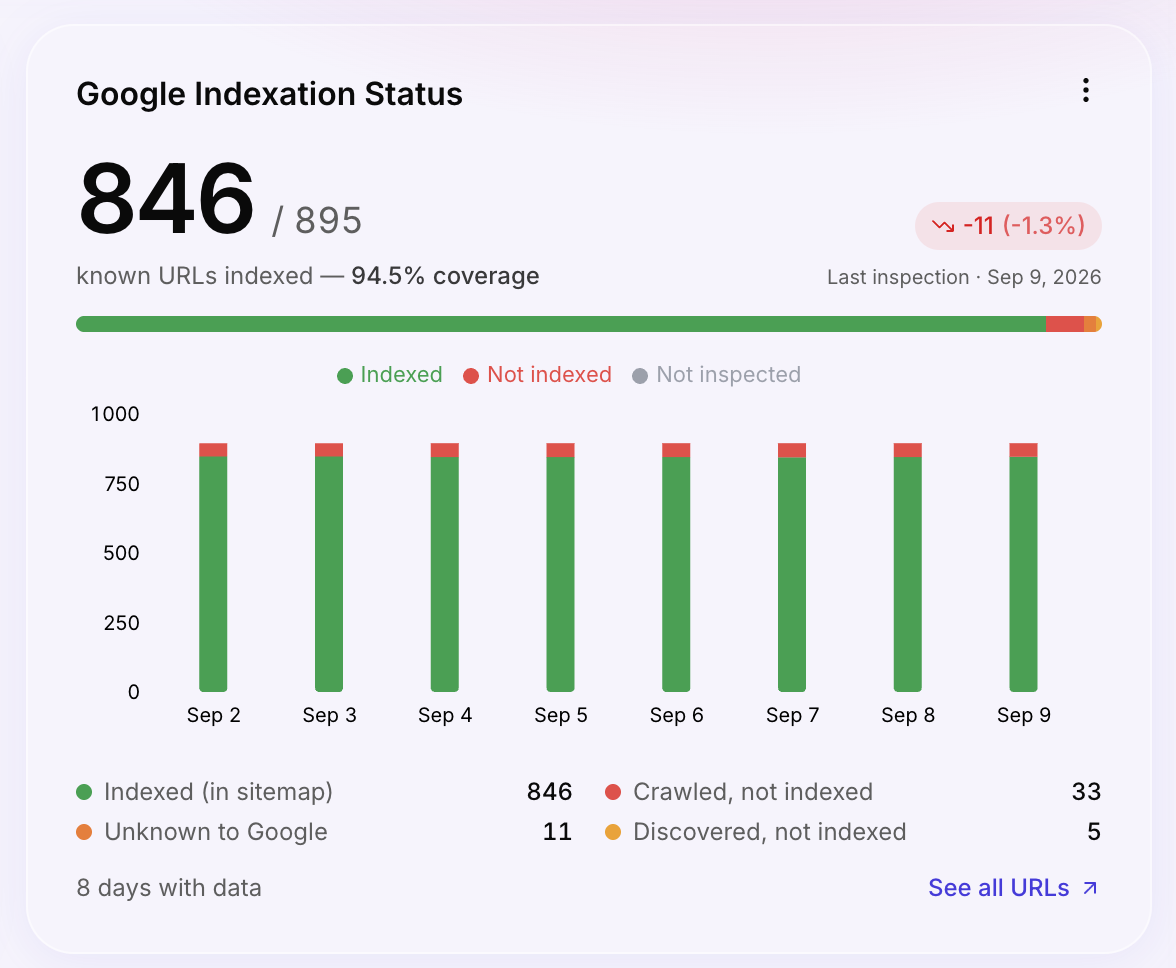
Parce que Sublim est aussi votre analytics, il fait une chose qu'un outil SEO isolé ne peut pas faire : il croise les pages indexées avec le vrai trafic organique, pour repérer les pages indexées qui ne reçoivent aucune visite, ce contenu à faible valeur qui tire souvent le reste vers le bas. Il ne forcera pas Google à indexer une page (rien ne le peut), mais il rend le diagnostic rapide et concret au lieu d'une devinette.