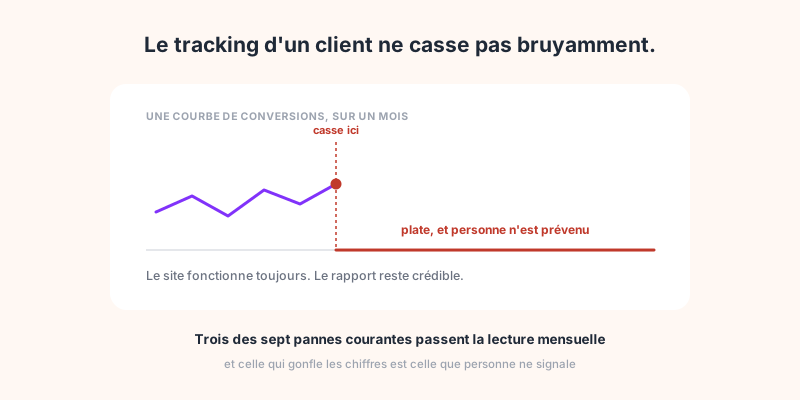
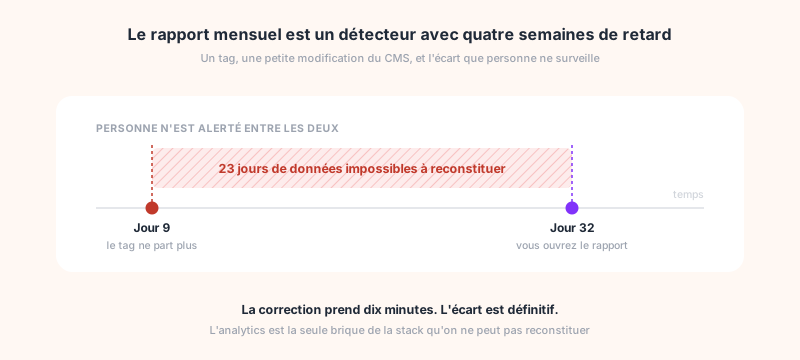
Vous ouvrez le rapport d'un client le 2 du mois. La courbe des conversions est plate, et elle l'est depuis le 9 du mois précédent. Trois semaines de données sur un compte que vous êtes payé pour surveiller, et le premier à s'en apercevoir, c'est vous, le rapport déjà à moitié rédigé.
La panne en elle-même est banale : une mise à jour de thème, une modification dans le CMS, un champ de formulaire renommé. Il n'en faut pas plus pour que le tag cesse de partir, ce bout de script posé dans vos pages qui transmet chaque visite à votre outil de mesure. Ce qui coûte cher, c'est l'écart entre le jour où elle est arrivée et le jour où vous l'avez vue, parce que l'analytics est la seule brique de votre stack qu'on ne peut pas reconstituer après coup. Cet article porte sur la réduction de cet écart : les façons dont le tracking d'un client casse, pourquoi le nombre de clients les masque, et ce qu'une alerte doit réussir avant de valoir la peine d'être activée.
La panne ne coûte rien, le délai si
La plupart des choses qui cassent chez un client se signalent d'elles-mêmes. Le site tombe et quelqu'un téléphone. Un formulaire n'envoie plus rien et le client remarque le silence. Un paiement échoue et l'argent n'arrive pas.
Le tracking échappe à cette règle, parce que rien en aval n'en dépend. Le site continue de servir ses pages, les formulaires fonctionnent, le client continue de vendre. Le seul symptôme est un chiffre plus bas qu'il devrait l'être, dans un outil que vous seul consultez, et une fois par mois.
C'est aussi pour cette raison que la perte est définitive. Un déploiement raté se remet en arrière, une facture perdue se réédite. Des visites qui n'ont pas été enregistrées n'existent nulle part, et remettre le tag en place ne les fera pas réapparaître. Corrigez au jour 23 et vous devez encore une explication au client pour les jours 9 à 23, ce qui est une conversation plus désagréable que la correction elle-même.
Sept façons dont le tracking d'un client casse
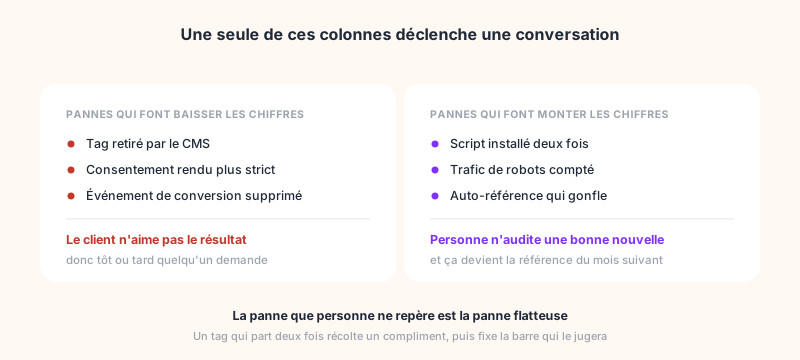
Voici les pannes qui produisent un rapport d'apparence crédible plutôt qu'une erreur visible. Chacune a un symptôme différent, et ça compte : celles qui font baisser vos chiffres finissent par susciter une question, celles qui les font monter n'en suscitent jamais.
| Ce qui s'est passé | Ce que montre le rapport | Repéré à la lecture mensuelle ? |
|---|---|---|
| Tag retiré par une modification du CMS ou du thème | Tout s'arrête à une date précise | Finalement oui, un zéro se voit |
| Tag installé deux fois | Pages vues et sessions gonflées | Non. Personne n'audite une bonne nouvelle |
| Le tag manager charge, votre tag ne part pas | Plus aucune donnée, exactement comme un tag retiré | Le zéro se voit, la cause non : GTM est bien là |
| Bannière de consentement reconfigurée | Une marche, souvent 20 à 40 % | Pris pour un mauvais mois une fois sur deux |
| Événement de conversion renommé ou supprimé | Trafic normal, conversions à zéro | Seulement si quelqu'un regarde au-delà du trafic |
| Redirection ou perte des UTM | Bons totaux, mauvais canaux | Non. Le chiffre que vous vérifiez est juste |
| Tunnel de paiement sur un autre domaine | Sessions coupées, chiffre d'affaires sans source | Non. Ça ressemble à une campagne qui performe mal |
Trois des sept n'apparaissent pas du tout à la lecture mensuelle. La plus embêtante est la seule ligne qui fait monter les chiffres au lieu de les faire descendre : un tag qui part deux fois ne provoque pas de réclamation, il provoque un compliment, puis il devient la référence à laquelle le mois suivant sera comparé. Toutes les autres pannes du tableau ont au moins l'honnêteté de ressembler à une mauvaise nouvelle. Le cas du tag manager est à part : le zéro se voit, mais le réflexe de vérification renvoie un bon résultat, donc on cherche la cause partout sauf là où elle est.
Deux d'entre elles méritent un traitement à part. L'attribution qui se réfugie dans le direct ou le non attribué est un diagnostic en soi, que le guide sur les chutes de trafic déroule. Et le cas de la bannière de consentement tient moins à la bannière qu'à ce que vous mesurez après elle, sujet de cet article.
Pourquoi le nombre de clients masque le problème
Avec un seul site, vous verriez la panne. Vous le consultez souvent, vous savez à quoi ressemble un mardi, et une courbe plate saute aux yeux.
Le calcul change avec le nombre de clients. Admettons un incident de tracking par client et par an, ce qui est prudent pour un site dont le CMS est vivant et où plusieurs personnes déploient. À 30 clients, ça fait un incident quelque part dans votre parc de sites tous les quinze jours, réparti sur des comptes que vous ouvrez une fois par mois chacun. Les incidents ne sont pas plus rares qu'avant, ils sont simplement assez dilués pour qu'aucun compte ne paraisse en panne.
C'est pire sur les comptes qui comptent le moins. Le petit forfait que vous survolez est précisément celui où une panne survit le plus longtemps, et c'est aussi le client le plus susceptible de lire le seul chiffre qui a bougé et de vous interroger dessus au moment du renouvellement.
Pourquoi la plupart des alertes finissent désactivées
Tout le monde a déjà coupé un système d'alertes après l'avoir mis en place. La raison est presque toujours la même : l'alerte comparait hier à avant-hier.
Faites ça et vous alertez tous les lundis sur un site B2B, tous les week-ends sur un site grand public, et à chaque jour férié sur les deux. Au bout de trois semaines plus personne ne lit les emails, ce qui est pire que de ne rien avoir, puisque vous vous croyez couvert.
Un système d'alertes qui survit à un vrai parc de clients doit réussir quatre choses, et toutes consistent à ne pas crier au loup :
Comparer ce qui est comparable. La référence doit être le même jour de semaine sur plusieurs semaines, pas la veille. Un lundi n'est pas un dimanche calme.
Avoir un plancher de volume. Sur un site à 12 sessions par jour, une chute à 5 n'est que du bruit. Alerter en dessous d'un certain seuil garantit des fausses alertes, donc l'alerte ne doit simplement pas partir.
Se refermer seule. Une alerte qui s'ouvre et ne se referme jamais devient une liste que personne ne vide. Si le chiffre revient, l'incident doit se clore de lui-même et le dire.
Se méfier d'abord de lui-même. Si la même anomalie apparaît sur un quart des sites surveillés la même nuit, l'explication la plus probable n'est pas qu'un quart de vos clients ont cassé leur site simultanément. C'est que l'outil de mesure est tombé. Un système qui vous envoie quand même l'email vous apprend à l'ignorer.
Ce que fait Sublim
Chaque client est un projet dans un seul espace de travail, et les contrôles tournent par projet sans que personne change de compte. Deux tournent automatiquement. Une vérification nocturne charge la page d'accueil et enregistre ce qu'elle a réellement trouvé : le script de suivi présent, aucun script et aucune donnée entrante, un tag manager qui charge sans que le tag Sublim parte, ou un site inaccessible. Et un passage quotidien sur les données de la veille cherche cinq anomalies :
| Détection | Ce qui la déclenche réellement |
|---|---|
| Tracking arrêté | Un site qui avait des sessions au moins 5 jours sur les 7 derniers devient muet. Un email par incident, pas un par jour |
| Chute de trafic | Sessions à la moitié ou moins de la moyenne du même jour de semaine sur les 4 semaines précédentes, et seulement au-dessus de 50 sessions. Se referme à 70 % de la référence |
| Conversion arrêtée | Un événement qui partait au moins 5 fois par jour depuis 6 jours s'arrête. Les événements du tracker comme page_view ou scroll sont exclus, donc ce sont bien les vôtres qui sont surveillés |
| Commandes à zéro | Les commandes s'arrêtent alors que les paniers continuent, ce qui distingue un événement d'achat cassé d'une semaine calme |
| Trafic anormal | Trois fois la référence avec une seule source derrière l'essentiel, ce qui est en général un robot ou un pic de référent plutôt qu'une bonne journée |
| Script installé deux fois | Plus de 30 % des pages vues comptées en double, sur les sites au-dessus de 100 pages vues par jour. Se résout quand le second script est retiré |
La dernière mérite à elle seule d'être surveillée, parce que c'est la panne du tableau que personne d'autre ne cherche. Elle gonfle au lieu de minorer, donc aucun client ne la signale, et elle relève discrètement la référence qui servira à juger le mois suivant.
La règle de méfiance envers soi-même est implémentée et pas seulement promise : si une anomalie touche au moins trois projets et un quart de tout ce qui est surveillé cette nuit-là, rien n'est envoyé et l'incident est consigné pour que l'équipe Sublim vérifie de son côté. Il arrivera donc qu'un vrai problème ne vous soit pas signalé à cause de cette règle. C'est le bon arbitrage, parce qu'un canal d'alertes auquel vous faites confiance vaut mieux qu'un canal exhaustif.
Les alertes arrivent par email et dans l'application, ou sur Slack si vous préférez qu'elles atterrissent là où l'équipe travaille déjà. Le choix de celles que vous recevez se règle par utilisateur, ce n'est pas une liste figée, et un incident qui se rétablit envoie son propre avis de résolution, pour que rien ne reste ouvert sur une liste à vider à la main.
Une limite à énoncer clairement, parce qu'elle découle des seuils ci-dessus et non du marketing : les alertes quotidiennes ont besoin d'un rythme auquel se comparer. Un site client actif moins de 5 jours sur 7, ou sous 50 sessions par jour, est en dessous de ce qu'un seuil sait juger sans crier au loup. Sur ces comptes, le point d'appui reste le statut d'installation vérifié chaque nuit, et il faut aller le lire dans la liste des projets. Ce sont vos plus petits clients, et ce sont aussi ceux où une panne survit le plus longtemps.