Publicas uma página, esperas uma semana e continua a não aparecer no Google. A Search Console diz «Detetada» ou «Rastreada», mas não indexada. Não estás a ser penalizado e não há nada tecnicamente avariado. A página simplesmente não passou a fasquia para entrar no índice do Google.
É um dos problemas de SEO mais comuns e pior compreendidos, porque entrar no Google não é um passo mas dois: a tua página tem de ser rastreada e depois o Google tem de decidir que vale a pena indexá-la. Este guia explica a diferença, mostra-te como ler o que a Search Console te está realmente a dizer, percorre as verdadeiras razões pelas quais as páginas não são indexadas e desmonta o mito do orçamento de rastreio que faz perder tanto tempo.
Rastreio e indexação são dois passos diferentes
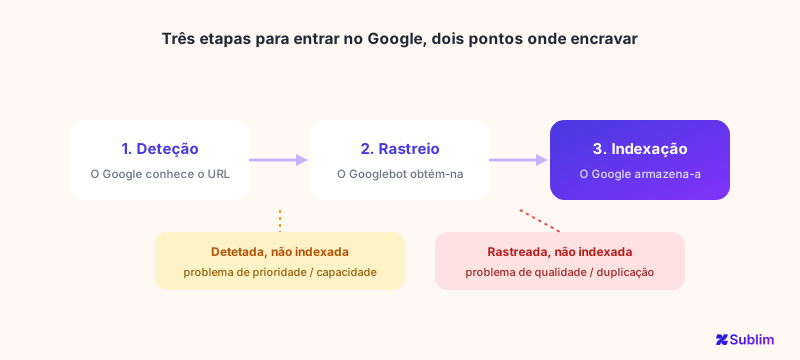
Diz-se «o Google não rastreou a minha página» querendo dizer «o Google não a indexou», mas são fases separadas, e saber qual falhou diz-te o que corrigir.
Uma página pode ficar presa em qualquer destas fases, e a solução é completamente diferente de cada vez. Uma página à espera de ser rastreada tem um problema de deteção ou de prioridade. Uma página rastreada mas não indexada tem um problema de qualidade ou de duplicação. Se tantas «correções» não mudam nada, é precisamente porque se confundem estes dois casos.
O que a Search Console te está mesmo a dizer
O relatório de Indexação de páginas do Google atribui a cada página excluída um estado concreto. A maioria nunca olha para além da contagem. Estes são os que vais mesmo ver, e o que cada um significa de facto:
| Estado | O que significa de facto |
|---|---|
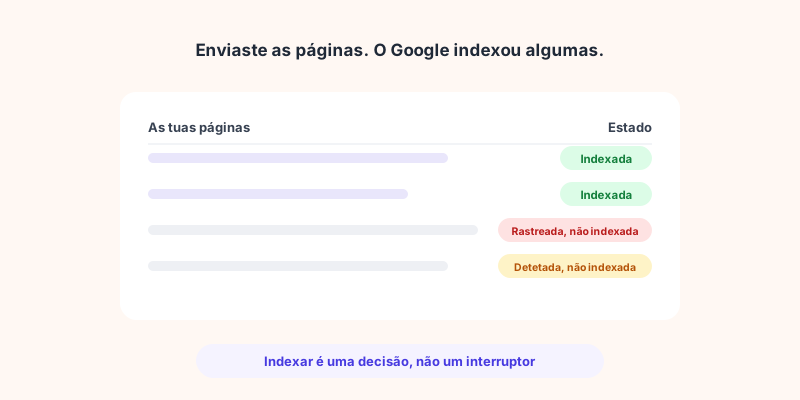
| Detetada, atualmente não indexada | O Google conhece o URL mas ainda não o rastreou. Muitas vezes um sinal de prioridade ou de capacidade de rastreio. |
| Rastreada, atualmente não indexada | O Google leu a página e escolheu não a indexar. Normalmente um sinal de qualidade do conteúdo. |
| Duplicada sem página canónica selecionada pelo utilizador | O Google vê a página como um quase-duplicado e indexou outra versão em vez dela. |
| Duplicada: o Google escolheu uma página canónica diferente da do utilizador | Definiste uma canónica, o Google ignorou-a e escolheu outra página. |
| Excluída por uma tag «noindex» | A página diz ao Google para não a indexar. Muitas vezes por acidente. |
| Bloqueada pelo ficheiro robots.txt | O Googlebot nem sequer teve permissão para a rastrear. |
| Soft 404 | A página parece vazia ou com aspeto de erro para o Google, mesmo que devolva um código 200. |
O estado é o diagnóstico. «Rastreada, não indexada» e «Detetada, não indexada» apontam para problemas completamente diferentes: começa sempre por aqui antes de mexer em seja o que for.
Porque é que as tuas páginas não são indexadas
Se tirares as etiquetas, quase todos os casos se resumem a um punhado de causas:
- Conteúdo fraco ou de baixo valor. A razão mais comum por trás de «Rastreada, atualmente não indexada». O Google rastreou a página, julgou-a não digna de ser guardada e seguiu em frente. As vítimas habituais são as páginas que repetem o que dezenas de outras já dizem.
- Duplicação e confusão de canónicas. Páginas quase idênticas (variantes de produto, URLs filtrados, texto repetido) levam o Google a escolher uma e a descartar as restantes. Tags canónicas ausentes ou contraditórias pioram a situação.
- Bloqueios acidentais por noindex ou robots.txt. Um
noindexperdido num template ou uma regra geral derobots.txtpodem deixar secções inteiras de fora em silêncio. Vale a pena verificar primeiro, porque é uma correção de uma linha. - Ligação interna fraca (páginas órfãs). Se nada no teu site liga a uma página, o Google pode nunca dar prioridade a rastreá-la. A deteção e a prioridade de rastreio dependem muito dos links internos.
- Soft 404 e erros técnicos. Páginas vazias, templates partidos ou respostas com aspeto de erro dizem ao Google que não há nada para indexar.
O orçamento de rastreio é o teu problema? (Quase nunca)
Sempre que surge o tema da indexação, alguém culpa o «orçamento de rastreio». Para a esmagadora maioria dos sites é uma pista falsa. O próprio guia do Google sobre gerir o orçamento de rastreio é claro: foi escrito para sites grandes (mais de 1 milhão de páginas) ou médios (mais de 10 000 páginas) com conteúdo que muda muito depressa. O Google diz claramente que se as tuas páginas costumam ser rastreadas no mesmo dia em que são publicadas, não precisas de ler esse guia de todo.
Por isso, se tens um site de empresa normal, um blogue ou uma loja com algumas centenas ou alguns milhares de páginas, o orçamento de rastreio não é a razão de faltarem as tuas páginas. A causa real é quase sempre a qualidade ou a duplicação, não a capacidade de rastreio. Perseguir o orçamento de rastreio num site pequeno é tempo que devias dedicar ao problema a sério.
Como resolver, passo a passo
- Começa no relatório de Indexação de páginas. Agrupa as páginas não indexadas por estado. O estado diz-te que problema tens antes de mudares o que quer que seja.
- Exclui primeiro os bloqueios acidentais. Procura tags
noindexperdidas e regras derobots.txt. São vitórias rápidas que podem libertar secções inteiras. - Corrige a duplicação. Define tags canónicas claras, consolida as páginas quase idênticas e faz com que cada página sobrevivente seja realmente distinta.
- Melhora o conteúdo fraco ou elimina-o. Para «Rastreada, não indexada», ou tornas a página bastante mais útil do que a concorrência, ou a podas para que deixe de diluir o teu site.
- Reforça os links internos. Liga às páginas importantes a partir de páginas relevantes já indexadas, para que o Google as descubra e lhes dê prioridade.
- Envia um sitemap limpo e usa «Solicitar indexação» para as páginas realmente valiosas, e depois tem paciência. Indexar é uma decisão, não um interruptor.
Como o Sublim ajuda
O Sublim dá-te as duas metades do quadro num só sítio. O seu crawler integrado revela os problemas técnicos que mantêm as páginas fora do índice: links partidos, títulos, meta descrições e conteúdos duplicados, metadados em falta e páginas lentas, tudo pontuado para que possas priorizar.
E a sua integração com a Search Console mostra o teu estado de indexação diretamente, páginas enviadas face às indexadas, com os erros e avisos que o Google reporta.
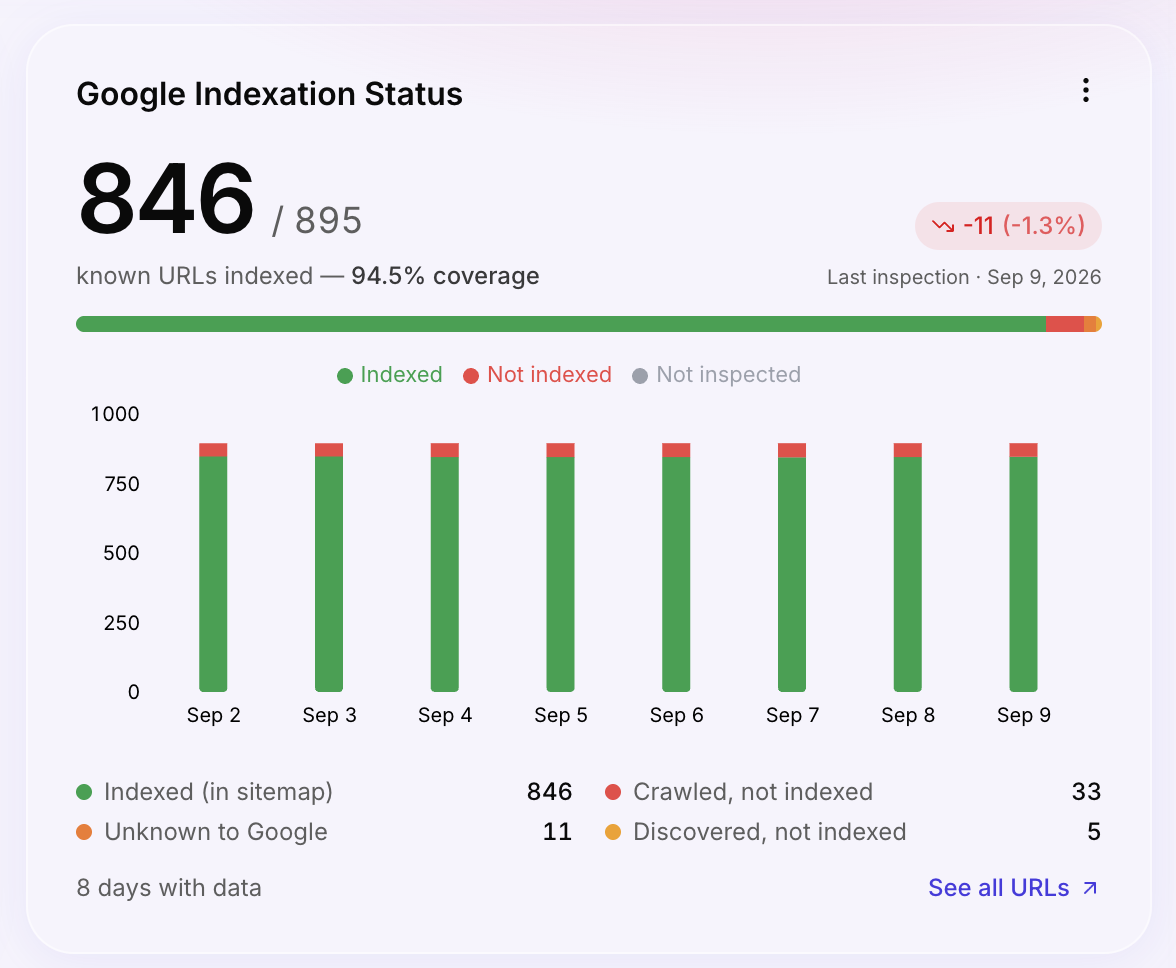
Como o Sublim também é a tua analítica, faz algo que uma ferramenta de SEO isolada não consegue: cruza as páginas indexadas com o tráfego orgânico real, para que detetes as páginas que estão indexadas mas não recebem visitas, esse conteúdo de baixo valor que muitas vezes arrasta o resto para baixo. Não vai obrigar o Google a indexar uma página (nada o faz), mas torna o diagnóstico rápido e concreto em vez de um palpite.